第13章 特定のデータフォーマットを扱う
CSV ファイルを扱う csv
CSV, TSV フォーマットのファイルの読み取り、書き込みを行う機能
-
CSV ファイルの読み込みと書き込み
関数名 解説 戻り値 reader(csvfile, dialect='excel', **fmtparams)CSV ファイルの各行を反復処理するような readerオブジェクトを返すreaderオブジェクトwriter(csvfile, dialect='excel', **fmtparams)CSV ファイルのデータを指定方法で書き込むための writerオブジェクトを返すwriterオブジェクト-
csvfileには、イテレータープロトコルをサポートするオブジェクトを指定 -
dialectには、以下の 書式化パラメーターセット 、またはDialectサブクラスのインスタンスを指定できる-
excelExcel で出力される CSV ファイル -
excel-tabExcel で出力される TSV ファイル -
unix終端記号を\nとするファイル
書式化パラメーターセットによる、各書式化パラメーターのデフォルト値パラメーター
セットdelimiter quatechar skipinitialspace lineterminator excel,"False \r\nexcel-tab\t"False \r\nunix,"False \nDialectクラスの主な属性属性 デフォルト 解説 delimiter,区切り文字 (1文字からなる文字列) quotechar"引用符文字 skipinitialspaceFalse Trueの場合、 delimiterの直後に続く空白は無視されるlineterminator\r\nwriterが使用する、各行の終わりを表す文字列
-
-
readerオブジェクトで CSV 読み込み"id","都道府県","人口(人)","面積(km2)" "1","東京都","13900000","2194.05" "2","神奈川県","9200000","2416.10" "3","千葉県","6200000","5157.50" "4","埼玉県","7300000","3797.75">>> import csv >>> with open("01_sample.csv", mode="r", encoding="utf-8") as f: ... reader = csv.reader(f) ... for row in reader: ... print(row) ... ['id', '都道府県', '人口(人)', '面積(km2)'] ['1', '東京都', '13900000', '2194.05'] ['2', '神奈川県', '9200000', '2416.10'] ['3', '千葉県', '6200000', '5157.50'] ['4', '埼玉県', '7300000', '3797.75']>>> dialect = reader.dialect >>> dialect.quotechar '"' >>> dialect.lineterminator '\r\n' >>> dialect.doublequote True >>> dialect.skipinitialspace False >>> dialect.delimiter ',' -
writerオブジェクトで CSV 書き込みメソッド名 解説 writerow(row)データを書式化し、 writerのファイルオブジェクトへ書き込むrowには文字列か数値のイテラブルを指定writerows(rows)複数行を書き込む rowsにはwriterow()のrowと同様のオブジェクトのイテラブルを指定>>> with open("writetest.tsv", mode="w", encoding="utf-8") as f: ... writer = csv.writer(f, dialect="excel-tab") ... for i in range(5): ... writer.writerow([i, "x", i, "=", i**2]) ... 11 11 11 11 120 x 0 = 0 1 x 1 = 1 2 x 2 = 4 3 x 3 = 9 4 x 4 = 16 -
辞書データを用いた CSV ファイルの読み込みと書き込み
-
class
DictReader(f, fieldnames=None, restkey=None, restval=None, dialect='excel', *args, **kwargs)-
fイテレータープロトコルをサポートするオブジェクト -
fieldnames辞書のキーをシーケンスで指定 (未指定の場合はfの最初の行の値が使用される) -
restkeyrestval実際に読み込んだデータが、フィールド数 (fieldnamesまたはfの1行目) と不一致である場合に使用される値- 実データのフィールド数が多い場合、残りの列の値はリストとしてまとめられて
restkeyキーの値となる - 実データのフィールド数が少ない場合、足りない値は
restvalによって埋められる
- 実データのフィールド数が多い場合、残りの列の値はリストとしてまとめられて
-
dialect(略) -
戻り値
DictReaderオブジェクト
-
-
class
DictWriter(f, fieldnames, restval='', extrasaction='raise', dialect='excel', *args, **kwargs)-
f(略) -
fieldnames書き込み時に渡される辞書の値をどの順でファイルへ書き出すかをシーケンスで指定 -
restvalfieldnames に指定のキーが書き込みデータに存在しない場合に値として使用する文字列を指定 -
extrasactionfieldnames に存在しないキーが書き込みデータに存在する場合の動作-
raiseValueError 送出 -
ignore無視される
-
-
dialect(略) -
戻り値
DictWriterオブジェクト
>>> import csv >>> with open('01_sample.csv', mode='r', encoding='utf-8') as f: ... for row in csv.DictReader(f): ... print(row) ... {'id': '1', '都道府県': '東京都', '人口(人)': '13900000', '面積(km2)': '2194.05'} {'id': '2', '都道府県': '神奈川県', '人口(人)': '9200000', '面積(km2)': '2416.10'} {'id': '3', '都道府県': '千葉県', '人口(人)': '6200000', '面積(km2)': '5157.50'} {'id': '4', '都道府県': '埼玉県', '人口(人)': '7300000', '面積(km2)': '3797.75'} -
-
DictWriterには、ヘッダーを書き込むメソッドwriteheader(row)があるimport csv data = [ {'都道府県': '東京都', '人口密度(人/km2)': 6335}, {'都道府県': '神奈川県', '人口密度(人/km2)': 3807}, {'都道府県': '千葉県', '人口密度(人/km2)': 1202}, ] with open('result.csv', newline='', mode='w', encoding='utf-8') as write_file: fieldnames = ['都道府県', '人口密度(人/km2)'] # ヘッダーの要素順を指定する writer = csv.DictWriter(write_file, fieldnames=fieldnames) writer.writeheader() # DictWriterのメソッドwriteheaderを使用してヘッダー行を書き込み writer.writerows(data) # データの一括書き込み
-
-
-
Dialect を推測して生成する Sniffer クラス
クラスメソッド名 解説 戻り値 sniff(sample, delimiters=None)sampleのデータを解析し、推測結果を返すDialectサブクラスhas_header(sample)ヘッダーの有無を判定する bool
13.2 JSON を扱う json
JSON フォーマットを扱うための機能
-
JSON のエンコードとデコード
-
関数
dump(obj, *, skipkeys=False, ensure_ascii=True, check_circular=True, allow_nan=True, cls=None, indent=None, separators=None, default=None, sort_keys=False, **kw)-
objエンコード対象オブジェクト -
skipkeysTrue の場合、辞書キーにstrintfloatboolNone以外を指定しても TypeError を送出しない -
ensure_asciiTrue の場合、非 ascii 文字列はエスケープされる (日本語などをそのまま出力したい場合は False にする) -
check_circularTrue の場合、リストや辞書での循環参照がチェックされ無限再帰を防ぐ (False で循環参照が見つかると RecursionError) -
allow_nanFalse の場合、許容範囲外 float (nan, inf, -inf) を検出すると ValueError -
clsカスタマイズしたJSONEncoderサブクラスを使用する場合に指定 -
indentインデントのスペース数を整数指定 -
separatorsセパレーター文字を(item_separator, key_separator)のタプルで指定 -
defaultシリアライズできないオブジェクトに対して呼び出す関数を指定 -
sort_keysTrue の場合、キーでソートされる - 戻り値 JSON 形式の str
>>> import json >>> dbinfo = [{"db1": {"id": "user1", "pw": "pass1", "failover": True, "host": [{"ip": "192.168.0.1", "port": 8021},{"i\p": "192.168.0.2", "port": 8021}]}}, {"db2": {"id": "user2", "pw": "pass2", "failover": False, "host": [{"ip": "192.168\.0.3", "port": 8021}]}}] >>> print(json.dumps(dbinfo, indent=4)) [ { "db1": { "id": "user1", "pw": "pass1", "failover": true, "host": [ { "ip": "192.168.0.1", "port": 8021 }, { "ip": "192.168.0.2", "port": 8021 } ] } }, { "db2": { "id": "user2", "pw": "pass2", "failover": false, "host": [ { "ip": "192.168.0.3", "port": 8021 } ] } } ] -
-
関数
loads(s, *, cls=None, object_hook=None, parse_float=None, parse_int=None, parse_constant=None, object_pairs_hook=None, **kw)-
sデコード対象のオブジェクト (str, bytes, bytearray) -
clsカスタマイズしたJSONDecoderサブクラスを使用する場合に指定 -
object_hookオブジェクトリテラルがデコードされた結果に対して呼ばれる関数を指定 (デコード結果が関数戻り値に置換される) -
parse_floatJSON に含まれる浮動小数点数 (文字列) を扱う関数を指定 (None ならfloat()が使用される) -
parse_intJSON に含まれる整数 (文字列) を扱う関数を指定 (None ならint()が使用される) -
parse_constantJSON に含まれる'-Infinity''Infinity''NaN'を扱う関数を指定 -
object_pairs_hookペアの順序付きリストのデコード結果に対して呼ばれる関数を指定 (object_hookより優先される) - 戻り値 Python オブジェクト
>>> jsonstr = '[{"name": "smith", "age": 41, "height": 167.5}, {"name": "sabakan", "age": 3}]' >>> pyobj = json.loads(jsonstr) >>> pyobj [{'name': 'smith', 'age': 41, 'height': 167.5}, {'name': 'sabakan', 'age': 3}] >>> type(pyobj) <class 'list'> >>> type(pyobj[0]) <class 'dict'> >>> pyobj[0] {'name': 'smith', 'age': 41, 'height': 167.5} -
エンコード変換表Python → JSON 辞書 オブジェクト リスト、タプル 配列 文字列 文字列 整数、浮動小数点数、
intやfloatの派生列挙型数値 True true False
デコード変換表JSON → Python オブジェクト 辞書 配列 リスト 文字列 文字列 数値 整数、浮動小数点数 true True false False null None -
-
JSON のエンコードとデコード (ファイルオブジェクト)
- 関数
dump(obj, fp, *, cls=None, object_hook=None, parse_float=None, parse_int=None, parse_constant=None, object_pairs_hook=None, **kw)-
fp書き込み先ファイルオブジェクト - 戻り値 None
-
- 関数
load(fp, *, cls=None, object_hook=None, parse_float=None, parse_int=None, parse_constant=None, object_pairs_hook=None, **kw)-
fp読み込み元ファイルオブジェクト - 戻り値 Python オブジェクト
-
- 関数
-
JSON のコマンドラインインターフェースを提供している json.tool
- JSON 文字列 (`curl で受け取ったレスポンスなど) を渡すだけで整形できる
-
python -m json.tool -hでヘルプ
13.3 INI ファイルを扱う configparser
Windows OS で設定ファイルとして多く使用される INI ファイル (他の場所でも多く使用されている) 、および INI ファイルに似た構造の設定ファイルを扱う
-
サポートされる INI ファイルの構造 (webドキュメントより)
- 各セクションは
[セクション名]で始まる領域- デフォルトではセクション名は改行を含まない任意の文字列
- セクション名は大文字小文字が区別される
- セクション内には、指定文字列 (デフォルトでは、
=および:) を使った キー/値 要素が並ぶ- キー、値はすべて文字列として扱われるが、取得時に変換もするメソッドが用意されている
-
getboolean()getint()getfloat()
-
- キーは大文字小文字が区別されず、すべて小文字として扱われる (書き込み時も小文字)
- キー、値はすべて文字列として扱われるが、取得時に変換もするメソッドが用意されている
- キー、値の前後の空白は基本的に除去される
- 値は複数行に渡って記述でき、その場合は2行目以降を1行目よりインデントさせる
- コメントは行頭に特定文字 (デフォルトでは、
#および;) を付けた行全体 (インデントも可能) - 最初のセクション名は省略可能で、その場合は読み込み時にオプション
allow_unnamed_section=Trueとすることで、無名セクションを扱える- 無名セクションへは、セクション名の代わりに
configparser.UNNAMED_SECTIONを使用してアクセスする
- 無名セクションへは、セクション名の代わりに
- 各セクションは
-
INI ファイルを読み込む
ConfigParser インスタンスのメソッド
メソッド 解説 戻り値 read_string(string)指定文字列を INI フォーマットとして解析する None read(filenames, encoding=None)指定した INI ファイルを読み込む filenamesにはリストで複数渡せるlist (解析できたファイル名) sections()読み込んだ INI 内のセクション名一覧を返す list (セクション名) options(section)指定セクションのキー一覧を返す list (キー) - DEFAULT セクション
- 特定セクションの存在しないキーを参照した場合、DEFAULT セクションのキーを参照して値が返される
- DEFAULT セクション
-
INI ファイルの高度な利用 (値の補完)
-
INI ファイル内の他の場所に記載した内容を再利用 (値の補完 = interpolation) する
-
値の補完方法クラスをコンストラクタに指定することで行う (クラスは configparser モジュール内)
-
ConfigParser(interpolation=BasicInterpolation)(指定しない場合と同じ) ConfigParser(interpolation=ExtendedInterpolation)
BasicInterpolation (セクション内の値補完.%(キー)sで参照する)[USER_A] home_dir = /home/user_a mail_dir = %(home_dir)s/mail group = Developer>>> config = ConfigParser() >>> config.read('config_interp.ini') ['config_interp.ini'] >>> config['USER_A']['mail_dir'] '/home/user_a/mail'
ExtendedInterpolation (セクション外も補完可能:${キー}${セクション名:キー}で参照する)[USER_A] home_dir = /home/user_a mail_dir = ${home_dir}/mail group = Developer [USER_B] group = ${USER_A:group}>>> from configparser import ConfigParser, ExtendedInterpolation >>> config = ConfigParser(interpolation=ExtendedInterpolation()) >>> config.read('config_exinterp.ini') ['config_exinterp.ini'] >>> config['USER_B']['group'] 'Developer' -
-
13.4 YAML を扱う PyYAML
-
YAML ファイルの読み込み
関数名 解説 戻り値 load(stream, Loader)YAML で記述されたファイルを読み込む Python オブジェクト load_all(stream, Loader)「---」で区切られた YAML で記述されたファイルを読み込む Python オブジェクト (generator) safe_load(stream)load()にLoader=yaml.SafeLoaderを指定したものPython オブジェクト safe_load_all()load_all()にLoader=yaml.SafeLoaderを指定したものPython オブジェクト (generator) -
関数の引数
Loaderに指定できるものLoader 解説 BaseLoader基本的な YAML のみをロードする
すべてのスカラーは文字列としてロードされるSafeLoaderYAML のサブセットを安全にロードする FullLoader基本的に YAML の全機能を受け入れるが、任意コード実行は一部制限 (デフォルト Loader) UnsafeLoaderYAML の全機能を使用可能で、任意コード実行もできる -
YAML でキー
!!python/object:を指定して記載すると、任意の Python オブジェクトが生成可能- 生成オブジェクトから処理を実行可能
- この機能への対応が、Loader によって制御されている
単独ドキュメント--- database: host: localhost port: 3306 db: test user: test smtp_host: localhost>>> import yaml >>> with open("sample1.yml", "r") as f: ... y1 = yaml.safe_load(f) ... y1 ... {'database': {'host': 'localhost', 'port': 3306, 'db': 'test', 'user': 'test'}, 'smtp_host': 'localhost'}
複数ドキュメント--- order: 1 menu: ham --- order: 2 menu: egg>>> with open("sample2.yml", "r") as f: ... y2 = yaml.safe_load(f) # 複数ドキュメントに対して load() はエラー ... y2 ... Traceback (most recent call last): ...(略)... yaml.composer.ComposerError: expected a single document in the stream in "sample2.yml", line 2, column 1 but found another document in "sample2.yml", line 4, column 1>>> with open("sample2.yml", "r") as f: ... y3 = yaml.safe_load_all(f) # 複数ドキュメントに対しては load_all() ... for y in y3: # load_all() はジェネレーターを生成し、毎取得時にファイル参照するので、with 内で読み込みを完了させる ... y ... {'order': 1, 'menu': 'ham'} {'order': 2, 'menu': 'egg'} -
-
YAML ファイルの書き込み
関数名 解説 戻り値 dump(data, stream=None, Dumper=Dumper, **kwds)Python オブジェクトを YAML 文字列へ変換する 文字列または streamで指定した型safe_dump(data, stream=None, **kwds)dump()と同じだが、標準の YAML タグ以外の変換はエラー文字列または streamで指定した型-
**kwds部分の代表的引数引数 解説 indentインデントのスペース数を数値指定 explicit_startTrue の場合、先頭に「---」が含まれる (デフォルトは False) default_flow_styleTrue の場合 (デフォルト)、YAML のフロースタイル
False の場合、ブロックスタイル
(※動作確認時は、デフォルトが False になっていた)>>> hosts = {'web_server': ['192.168.0.2', '192.168.0.3'], 'db_server': ['192.168.10.7']} >>> with open('dump.yml', 'w') as f: ... f.write(yaml.dump(hosts, default_flow_style=False)) ... 66db_server: - 192.168.10.7 web_server: - 192.168.0.2 - 192.168.0.3
-
13.5 Excel を扱う openpyxl
MS Excel の読み書きを Python で行うための機能を提供する
pip install openpyxl
- Excel の読み込み
- 関数
load_workbook(filename, read_only=False, use_iterators=False, keep_vba=False, guess_types=False, data_only=False)-
filenameExcel ファイルパス -
read_onlyTrue の場合、読み取り専用となり編集できない -
data_onlyTrue の場合、セルの値が式の場合に評価結果を取得する -
戻り値
Workbookオブジェクト
-
- 参照
-
Workbookの属性sheetnamesで、ワークシート名のリストが取得可能 -
Workbookからはワークシート名をキーとして辞書と同様にWorksheetが取得可能 -
Worksheetからはセル名をキーとして辞書と同様にCellが取得可能- メソッド
cell(row=None, column=None, value=None)でも取得可能
- メソッド
-
Cellの値は属性valueで取得可能
-
- 関数
- Excel の書き込み
-
Cellに値を設定するには、辞書の値設定と同様に行う
Workbook のメソッドメソッド名 解説 戻り値 create_sheet(title=None, index=None)シートを index位置に挿入する (0 なら先頭)Worksheetオブジェクトsave(filename)ファイルパス filenameへ Excel ファイルを保存するNone
-
- スタイルの適用
- フォント
-
openpyxl.styles.Fontオブジェクトを作成し、セルのfont属性に設定する
-
- セルの色、模様 (塗りつぶし)
-
openpyxl.styles.PatternFillオブジェクトを作成し、セルのfill属性に設定する
-
- 罫線
-
openpyxl.styles.Borderオブジェクトを作成し、セルのborder属性に設定する-
Borderに設定する各辺の属性はopenpyxl.styles.Sideオブジェクトを設定する
-
-
- 文字位置
-
openpyxl.styles.Alignmentオブジェクトを作成し、セルのalignment属性に設定する
-
- フォント
- チャートの挿入
-
openpyxl.chartに様々なチャートあり (例LineChartBarChart)
-
注意点
- 表示形式が「ユーザー定義」のセルは注意、日付がシリアル値取得されるなどあり (openpyxl.utils パッケージに変換ツールなどが存在する)
- Excel ファイルが他で開かれていると、保存時に PermissionError が発生する
-
data_only=Trueで式の解決値を取得できるのは、Excel ソフトで一度以上開いた場合のみ- プログラムで書き込んで、Excel で開かないまま読み込むと解決値は取得できない
- これは Excel で開いた際に式解決が行われて結果がキャッシュされる為
13.6 画像を扱う Pillow
画像データ (JPEG, PNG など) を扱う機能 (拡大縮小、回転、色調変更、文字挿入 等) を提供する
pip install pillow
import PIL ※インポート時の指定に注意
-
画像読み込み (PIL.Image モジュール)
- 関数
open(file_path, mode='r', formats=None)-
file_path画像ファイルパス -
modeモード指定だが、'r' 以外は使用できない -
formats開くファイルのフォーマットを制限したい場合は、フォーマットをタプルかリストで指定 -
戻り値
Imageオブジェクト
-
- 関数
-
画像のサイズを変更する、回転する
- メソッド
resize(size, resample=None, box=None, reducing_gap=None)-
sizeリサイズ後の画像サイズ (ピクセル) をタプル (width, hight) で指定 -
resampleリサンプリングフィルターを指定-
PIL.Image.NEAREST最近傍 -
PIL.Image.BILINEARバイリニア -
PIL.Image.BICUBICバイキュービック -
PIL.Image.LANCZOSランチョス PIL.Image.BOXPIL.Image.HAMMING
-
-
戻り値
Imageオブジェクト
-
- メソッド
rotate(angle, resample=0, expand=0, center=None, translate=None, fillcolor=None)-
angle回転角度 (反時計回り) -
戻り値
Imageオブジェクト
-
- メソッド
-
画像を保存する
- メソッド
save(file_path, format=None, **params)-
file_path保存ファイルパス -
format保存する画像のフォーマットを指定 (省略時はfile_pathの拡張子から自動判別) -
**paramフォーマットごとに異なるオプション指定 - 戻り値 None
-
- メソッド
-
テキストの埋め込み
-
ImageFont.truetype()でフォントオブジェクト (FreeTypeFont) を取得し、ImageDraw.Draw()でImageに対するImageDrawオブジェクトを作成し、ImageDraw.text()で画像に埋め込む - 関数
ImageFont.truetype(font=None, size=10, index=0, encoding='', layout_engine=None)-
fontTrueType のフォントファイルを設定 -
sizeフォントサイズを指定 -
index指定したフォントファイルに複数んおフォントが含まれている場合、ttc 番号を指定 -
戻り値 フォントオブジェクト (
FreeTypeFont)
-
- 関数
ImageDraw.Draw(im, mode=None)-
imImage オブジェクト -
戻り値
ImageDrawオブジェクト
-
- メソッド
ImageDraw.text(xy, text, fill=None, font=None, anchor=None, spacing=4, align='left', direction=None, features=None, language=None, stroke_width=0, stroke_fill=None, embedded_color=False)-
xyテキストを埋め込む座標をタプル (x, y) で指定 (anchor指定で実位置に変化あり) -
text埋め込むテキスト -
fillテキストの色指定 -
fontフォントオブジェクトを指定 - 戻り値 None
-
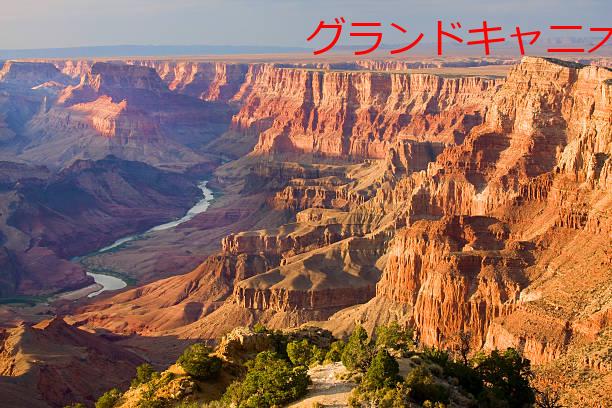
>>> from PIL import Image, ImageDraw, ImageFont
>>> ifont = ImageFont.truetype(r'C:\Windows\Fonts\Meiryo UI\meiryo.ttc', size=40)
>>> image = Image.open("GrandCanyon.jpg")
>>> idraw = ImageDraw.Draw(image)
>>> idraw.text((306,10), "グランドキャニオン", font=ifont, fill='red')
>>> image.save('GrandCanyon_withText.jpg')
元画像

テキスト埋め込み後画像
-
Tatsuya ISHIGAKI さんが1年以上前に更新 · 2件の履歴